 EMZETT.
Hashing
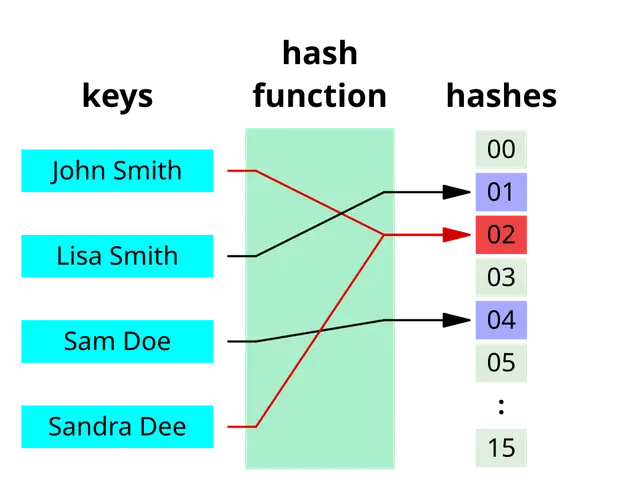 Bild: Jorge Stolfi, Public domain, Wikimedia Commons

Kurz: Ein Verfahren, das beliebig große Daten deterministisch auf einen Wert fester Länge (den “Hash”) abbildet — Einbahnstraße, aus dem Hash lassen sich die Originaldaten nicht zurückrechnen.
Genauer: Anders als Verschlüsselung ist Hashing nicht umkehrbar. Wichtige Eigenschaften: Gleiche Eingabe erzeugt immer denselben Hash, schon eine minimale Änderung der Eingabe erzeugt einen komplett anderen Hash (Lawineneffekt), und es soll praktisch unmöglich sein, zwei verschiedene Eingaben mit demselben Hash zu finden (Kollisionsresistenz). Typische Einsatzzwecke: Passwörter speichern (nie im Klartext, immer gehasht), Integrität von Dateien prüfen, Datenstrukturen wie Hash-Tabellen. Bekannte Algorithmen: SHA-Familie, MD5 (veraltet, unsicher).
Im Detail
Der Lawineneffekt
Ein Beispiel zeigt den Lawineneffekt eindrucksvoll — schon ein einziges geändertes Zeichen erzeugt einen komplett anderen Hash:
$ echo -n "Passwort123" | sha256sum
8f3a2e1d... (Beispiel-Hash)

$ echo -n "Passwort124" | sha256sum
c91b7f4a... (komplett anderer Hash, obwohl nur eine Ziffer geändert wurde)
Im Schnitt ändert sich bei einer guten Hash-Funktion etwa die Hälfte aller Ausgabe-Bits, wenn man nur ein einziges Eingabe-Bit kippt — die Ausgabe verhält sich dadurch praktisch nicht von einer echten Zufallsfolge unterscheidbar, obwohl der Vorgang vollständig deterministisch ist.
Salting gegen Rainbow Tables
Beim sicheren Speichern von Passwörtern reicht reines Hashing allein nicht aus: Weil derselbe Klartext immer denselben Hash erzeugt, könnte ein Angreifer mit einer vorab berechneten Tabelle häufiger Passwörter und deren Hashes (eine “Rainbow Table”) gestohlene Hash-Werte im großen Stil abgleichen — einmal berechnet, funktioniert eine solche Tabelle gegen jede Datenbank, die dasselbe Hash-Verfahren ohne Salt nutzt. Die Lösung ist ein zufälliger “Salt”: Ein pro Nutzer einmaliger Zufallswert wird vor dem Hashen an das Passwort angehängt, sodass selbst identische Passwörter unterschiedlicher Nutzer unterschiedliche Hashes ergeben und vorab berechnete Tabellen nutzlos werden. Der Salt selbst muss dabei nicht geheim sein — er wird üblicherweise direkt neben dem Hash in der Datenbank gespeichert, seine Aufgabe ist nur, jede Berechnung einzigartig zu machen, nicht sie zu verstecken.
Langsame Hash-Funktionen für Passwörter
Für Passwörter werden zudem bewusst LANGSAME Hash-Algorithmen genutzt (z. B. bcrypt, scrypt, Argon2) statt schneller Allzweck-Algorithmen wie SHA-256 — ein Angreifer, der Millionen Passwörter pro Sekunde durchprobieren will (Brute-Force), wird durch die künstliche Verlangsamung massiv ausgebremst, während der einzelne Login-Vorgang für einen echten Nutzer trotzdem kaum spürbar langsamer wird. bcrypt hat dafür einen einstellbaren “Cost-Faktor”, der die Rechenzeit exponentiell erhöht und regelmäßig an schnellere Hardware angepasst werden kann; Argon2 (Gewinner der Password Hashing Competition 2015) geht noch einen Schritt weiter und lässt sich zusätzlich so konfigurieren, dass er viel Arbeitsspeicher benötigt (memory-hard) — das macht spezialisierte Angriffs-Hardware wie GPUs oder ASICs, die zwar extrem viele Rechenoperationen parallel ausführen können aber wenig Speicher pro Kern haben, deutlich weniger effektiv.
Kollisionsangriffe in der Praxis
Kryptografische Hash-Funktionen (wie SHA-256) unterscheiden sich von einfachen Prüfsummen-Algorithmen (wie CRC32): Erstere sind speziell so konstruiert, dass Kollisionen praktisch nicht absichtlich herbeigeführt werden können — Prüfsummen sind nur auf zufällige Übertragungsfehler optimiert, nicht auf Angreifer, die gezielt Kollisionen konstruieren wollen. Dass dieser Unterschied real ist, zeigte sich 2017 eindrucksvoll bei “SHAttered”: Google und das CWI Amsterdam veröffentlichten die erste praktisch durchgeführte Kollision für SHA-1 — zwei unterschiedliche PDF-Dateien mit identischem SHA-1-Hash, berechnet mit enormem Rechenaufwand (umgerechnet zehntausende CPU-Jahre). Das Ergebnis beschleunigte den bereits laufenden Umstieg vieler Systeme (u. a. Git, Zertifizierungsstellen) von SHA-1 auf SHA-256 oder neuere Verfahren erheblich.
Hashing als Datenstruktur-Grundlage
Neben der Sicherheitsanwendung ist Hashing auch ein zentrales Konzept in der Informatik allgemein: Hash-Tabellen (wie HashMap/HashSet in vielen Programmiersprachen) nutzen einen (meist nicht-kryptografischen, dafür sehr schnellen) Hash-Wert, um Daten anhand eines Schlüssels in nahezu konstanter Zeit wiederzufinden, statt eine Liste linear durchsuchen zu müssen — hier steht nicht Sicherheit im Vordergrund, sondern Geschwindigkeit und eine gute Verteilung der Werte, um Kollisionen innerhalb der Tabelle selten zu halten.
Siehe auch: SHA-256, Integrität, Schlüssel-Schloss-Prinzip